一、什么是「多模态」:让人工智能用多种感官认识世界
过去几年,我们熟悉的 大模型 大多还停留在「文字进、文字出」的阶段——你输入一段问题,它返回一段回答。但真实世界里,人类从来不是只靠文字认识世界的:我们看图片、听声音、读视频、辨图表。所谓多模态 大模型,就是让 人工智能 同时具备理解文字、图像、音频、视频等多种信息形态的能力,把不同「感官」统一到一个模型里处理,从而更贴近人类认知世界的方式。
二、它是怎么把图、声、文「打通」的
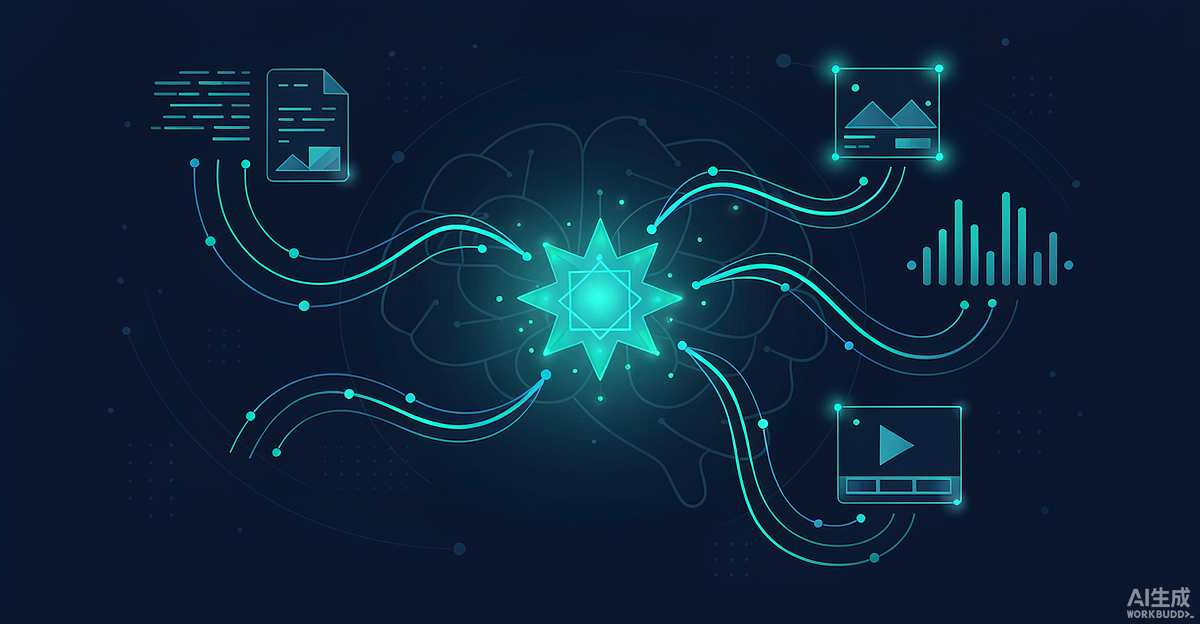
核心思路并不神秘。模型会先用各自的「编码器」把不同形态的信息转成同一种数学向量(也叫嵌入),就像把中文、英文都翻译成同一种内部语言;随后一个统一的 大模型 在共享的语义空间里做推理。比如你上传一张图表并问「这条曲线为什么在三月下跌」,模型先「看懂」图像内容,再结合你的问题生成回答——这正是 生成式AI 在理解侧的延伸。
视觉、听觉、语言三种能力的汇合
早期方案是「一个模型管一种模态」,彼此拼接;如今的趋势是端到端统一架构,让视觉、听觉、语言在同一个参数体系里互相增强。好处显而易见:你对着一张旅游照片说「帮我把背景换成秋天」,模型能同时理解画面与指令,直接产出结果,这背后就是多模态能力在支撑 AIGC 内容生产。
三、落地场景:多模态正在改变这些事
在办公场景,上传一份带图表的 PDF,AI 能直接总结要点并回答问题;在教育领域,学生拍一道几何题,AI工具 可识别图形、给出解题步骤;在电商与客服,用户发来商品照片,系统就能定位问题并给出处理建议。多模态让 AI 从「聊天窗口」走向「能处理真实素材的助手」,离我们日常工作更近了一步。
四、普通人如何上手这些能力
好消息是,你不必自己训练模型。主流厂商都提供了面向多模态的官方产品与开放接口,很多还是免费或低门槛的;开源社区(如 LLaVA、Qwen-VL 等)也持续放出可本地运行的方案。建议优先选择官方与正版渠道,既能获得稳定体验,也能避免来路不明的工具带来的隐私与合规风险。需要作图、配音、剪辑时,把多模态能力当作一类趁手的 AI工具 来用即可。
五、看清边界:多模态还不是万能的
也需要提醒的是,多模态能力仍有边界:对模糊、遮挡或罕见物体的识别可能出错,对复杂逻辑图的推理也可能「想当然」。把它的输出当作初稿而不是定论,在关键场景多加核实,并尽量通过官方与开源正版渠道使用,才能让这类 AI工具 真正可靠地为你所用。
小结
多模态 大模型 把「看懂图、听懂话、读得懂世界」变成了现实,是 人工智能 从单一文本走向通用感知的关键一步。它既延伸了 生成式AI 的理解边界,也拓宽了 AIGC 的创作可能。对普通用户来说,善用官方与开源的正版多模态工具,就能在工作和创作中实打实地提效。
© 版权声明
文章版权归作者所有,未经允许请勿转载。
相关文章


暂无评论...