一、从「单打独斗」到「组队干活」
过去一年,很多人对 人工智能 的印象,还停留在一个对话框里:你问,它答,一轮对话结束,任务也就结束了。但当任务变复杂——比如「调研三个竞品、写成报告、再配一张图表」——单个助手往往顾此失彼,容易在中途丢失上下文,也容易把不同环节混在一起做错。于是,一个新的方向开始被频繁讨论:让多个智能体分工协作,组成一支「AI 团队」。这就是多智能体(Multi-Agent)系统。它并不是让 大模型 变得更聪明,而是让它们学会像人类团队一样,把一个大目标拆开、分给不同角色、各自推进、最后汇总。
二、多智能体到底怎么「分工」
1. 角色扮演:每个智能体只干一件事
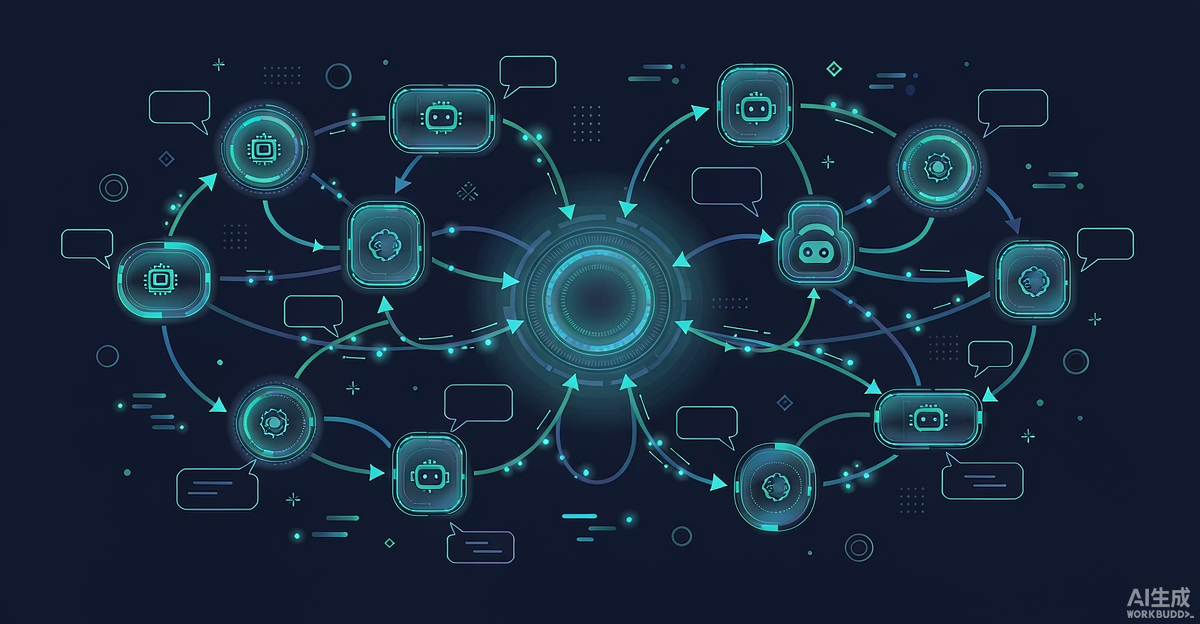
最常见的做法是给每个智能体设定一个身份和职责:一个负责拆解任务的「规划者」,一个负责查资料的「研究员」,一个负责动手的「执行者」,还有一个专门挑毛病的「评审员」。它们背后往往是同一个 大模型,只是被赋予了不同的系统提示词和工具权限。职责单一之后,每个环节的提示词可以写得更细,出错也更容易被发现。
2. 消息传递:像开会一样你一言我一语
协作靠的是消息。智能体之间通过共享的对话记录或工作区交换信息,把上一环的产出当作下一环的输入。「研究员」把找到的资料交给「写作员」,「写作员」交出初稿,「评审员」提出修改意见再打回重写,这个循环可以重复好几轮。整个过程就像一场持续进行的会议,只不过参会者全是程序。
3. 工具调用:让手和脑连起来
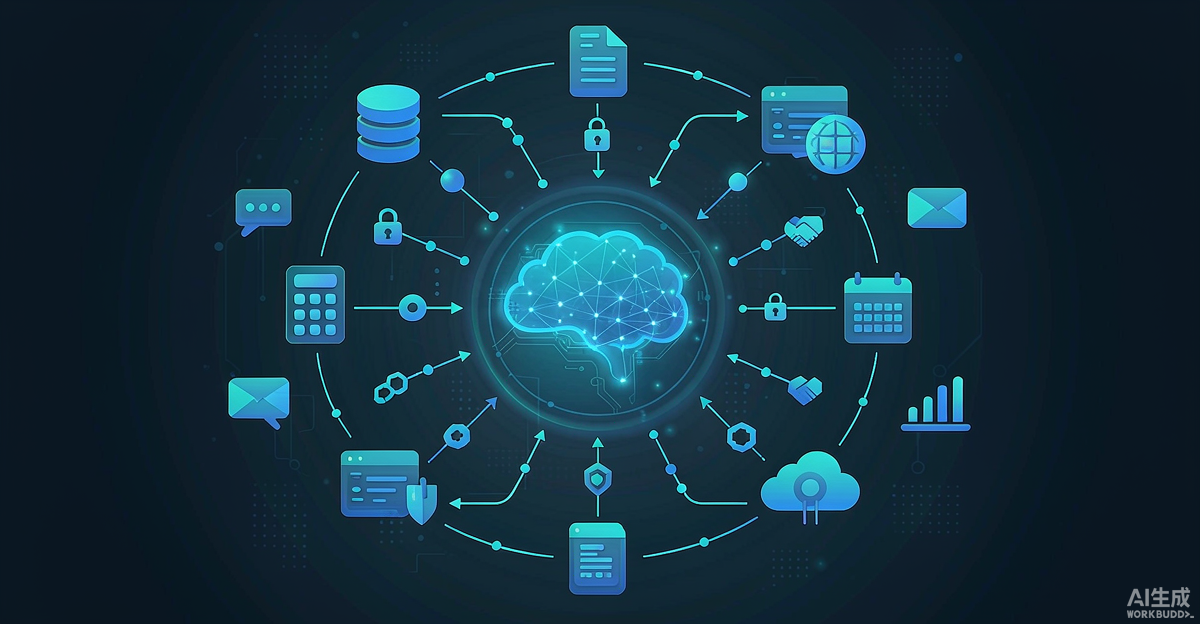
光会说还不够。现代的多智能体框架通常允许每个角色调用外部能力——联网搜索、读写文件、运行代码、查询数据库。这样一来,智能体不再只是「纸上谈兵」,而能把 生成式AI 的输出直接落到可验证的结果上,比如真的跑出一份数据表,而不是凭印象编一个数。
三、工程上的三个难点
1. 别让它们「聊个没完」
协作最大的成本是 Token 和时间。如果没有明确的终止条件和预算上限,几个智能体很容易互相客套、来回确认,把预算烧光却迟迟不出结果。成熟的方案会设定最大轮次、让「规划者」明确宣布任务完成,并对每一轮的价值做取舍。
2. 错误会沿着链路放大
单智能体出错影响有限,多智能体则可能把错误层层传递:「研究员」看错了一个数字,「写作员」把它写进结论,「评审员」没核对事实反而夸结构清晰。因此引入一个专门做事实核查的角色、并在关键节点要求引用来源,就显得格外重要。这也是 AIGC 类应用必须正视的可信度问题。
3. 成本与收益要对得上账
把一个任务交给五个智能体,开销可能是一次对话的好几倍。所以真正适合多智能体的,是那些「拆分后确实更容易做对」的任务——需要多轮检索、需要多种视角、或者需要边做边改的复杂活儿。简单的问答硬套多智能体,只会又慢又贵。
四、普通人的真实用法
不必自己写代码,也能用好这类 人工智能 能力。常见思路是把 AI工具 当作一个「团队召集人」:先让模型扮演规划者,把任务拆成清晰步骤;再逐步让它换角色执行,每一步都要求给出依据;最后让它以「评审员」身份回头检查。研究写报告、整理竞品资料、规划一份活动方案、给内容做多轮打磨,都可以套用这个流程。若想动手搭建,可从主流的开源编排框架入手,例如 LangChain、LangGraph、AutoGen、CrewAI 等,它们都提供了现成的多智能体抽象,学习曲线相对平缓。模型侧则可通过主流的官方平台与开源项目获取,如 ChatGPT、Claude、Gemini、通义千问、文心一言、Kimi、DeepSeek,以及可本地运行的 Llama、Qwen 系列配合 Ollama、LM Studio 体验。
五、保持冷静:它还不是「数字员工」
多智能体看起来很像一个全自动团队,但目前仍有明显边界。它们没有真正的长期记忆与目标感,所谓的「自主」更像是一套精心设计的流程编排;它们依赖外部工具才有行动力,工具失效就寸步难行;它们同样会幻觉,只是在多角色交叉检查下概率被压低了。更重要的是,越复杂的工作流越需要人来设定方向、审核关键产出、承担最终责任。把它当作一个执行力不错的助手团队,比当作可以完全托付的同事要现实得多。
小结
多智能体协作标志着 大模型 应用从「单点对话」走向「流程编排」:不再指望一个模型包打天下,而是让若干角色分工、传递消息、调用工具,共同完成一件复杂的事。它对提升 生成式AI 的任务完成度和 AIGC 内容质量确有帮助,但也带来了成本、错误放大和可信度上的新问题。对普通用户来说,先学会用「角色分工」的思路去指挥一个 AI工具,往往比急着追新框架更能见到实际收益。技术方向值得关注,理性使用才是关键。
© 版权声明
文章版权归作者所有,未经允许请勿转载。
相关文章

暂无评论...