
过去两年,生成式AI让大模型学会了写文章、画图、编代码。但很多人也发现一个问题:这些AI工具很会「说」,却不太会「想后果」——你让它规划一条路线,它未必能预判拐角之后会发生什么。于是,一个听起来有点科幻的概念越来越多地出现在人工智能前沿讨论里:世界模型(World Model)。它被不少人看作大模型走向下一阶段的钥匙,甚至被称为「通用人工智能的最后一公里」。今天我们就用大白话聊聊,世界模型到底是什么、为什么这么重要,以及它正在怎样改写生成式AI和AIGC的玩法。
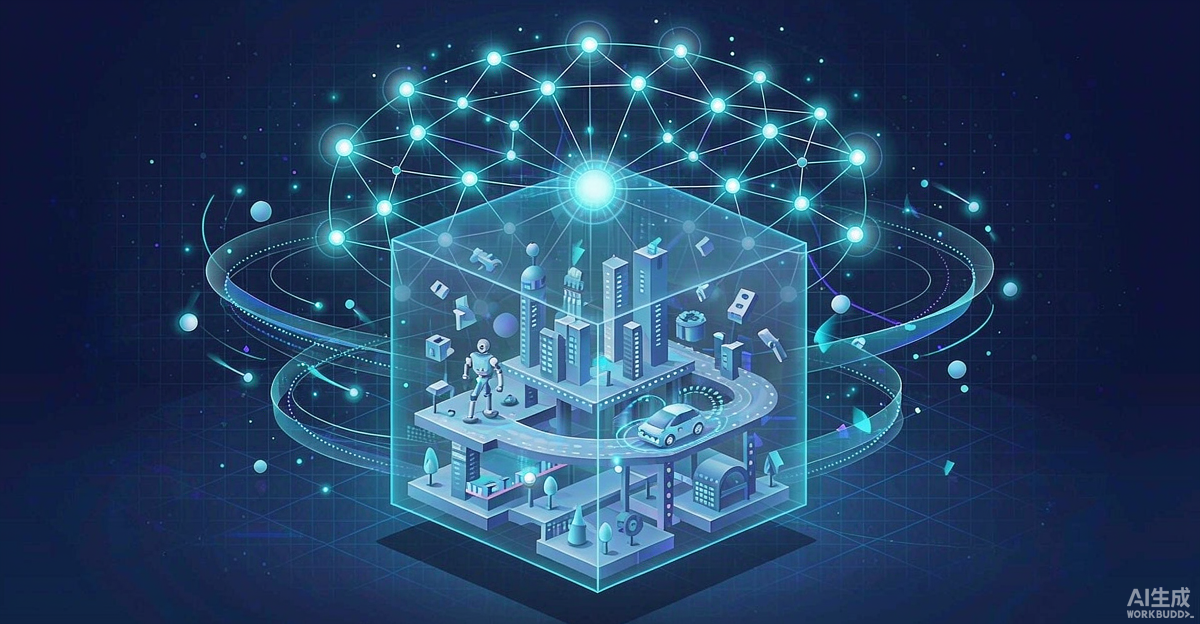
世界模型:让AI在「脑子里」提前排练一遍
先打一个比方。你接一杯水之前,不用真的把杯子倒满再撒出来,就能「想象」出水流、杯子倾斜、水面上升的整个过程,并提前判断该停在哪。这种在脑海里模拟世界运转、推演后果的能力,就是人类与生俱来的「世界模型」。
传统的大模型,本质是一个概率预测器——它根据学过的海量文字,预测下一个词最可能是什么。这让它在语言上很流畅,但它并没有真正「理解」一个杯子倾斜会怎样。而世界模型要做的,就是让AI工具在内部建立一个关于真实世界的动态模拟器:物体之间怎么碰撞、重力怎么作用、时间怎么流逝、一个动作会引发什么连锁反应。有了它,人工智能就不再只是「复读」见过的答案,而是能提前在脑中演练多种可能,再挑出最稳妥的那一条。
为什么说它是大模型的下一个关口
眼下的大模型虽然在语言和图像上惊艳,但普遍存在一个短板:缺乏对物理世界的常识。你问它「把一块冰放进热水里会发生什么」,它能答出来,但那是从文本里背下来的,而不是真的「推演」出来的。一旦场景稍微复杂、稍微脱离训练语料,它就容易一本正经地胡说。
世界模型恰好补的就是这一块。它让模型不再依赖「见过的例子」,而是靠「内在的物理直觉」去应对没见过的场景。这背后的意义重大:它被认为是让机器从「被动回答」走向「主动规划」的核心能力。也正因如此,不少研究者把世界模型视为通往真正通用人工智能(AGI)的关键一步——当一个智能体能在脑中准确预演世界,它才有资格谈「自主决策」和「长期目标」。
三个正在发生的落地场景
自动驾驶:在虚拟世界里「练车」
现实中的路测成本极高、风险也大。而基于世界模型的系统可以在虚拟世界里生成几乎无限多的极端路况——突然横穿的行人、结冰的路面、暴雨中的视线遮挡——让车辆在脑内「开过」成千上万次,再把学到的经验迁移回真实世界。这正是当前不少头部玩家探索的方向。
具身智能与机器人:先「想」后「做」
机器人搬箱子,如果先在世界模型里预演「这个角度会不会滑落」,就能避开大量试错和损坏。世界模型让机器人的大脑和身体更好地协同,也让训练成本大幅下降。
AIGC视频与游戏:让画面符合物理规律
很多人吐槽AI生成的视频里,人物手指会突然多一根、物体掉落的方式不自然——本质就是缺乏世界模型。未来更逼真、更连贯的文生视频与游戏画面,很大程度上要靠给生成式AI「装」上世界模型,让它懂物理、懂因果、懂时间连续性。
普通人该怎么看这股浪潮
对大多数读者来说,世界模型离日常还有点远,但它带来的趋势值得留意:AI工具正在从「会说」走向「会想」,从「聊天」走向「行动」。作为普通用户,现阶段更务实的做法是——继续用好成熟的生成式AI产品(如文心一言、通义千问、豆包、Kimi、DeepSeek 等官方平台),关注它们在多模态理解、长视频生成、智能体等方向的能力升级,因为这些能力背后,往往就藏着世界模型的影子。同时保持一份理性:世界模型目前仍处于快速演进阶段,很多演示还停留在实验室,距离真正的「通用智能」仍有不短的路。
小结
世界模型,是让大模型从「预测文字」走向「推演世界」的关键一步,它补上了当下人工智能最缺的物理常识与因果直觉。自动驾驶、机器人、AIGC视频,都将是它最先发力的战场。虽然它离通用智能还有距离,但理解这个概念,能帮我们更早看懂生成式AI接下来会往哪里走。对普通人而言,持续关注、理性使用、不急不躁,就是跟上这股浪潮最好的姿势。
© 版权声明
文章版权归作者所有,未经允许请勿转载。
相关文章


暂无评论...