你有没有过这样的困惑:同一个大模型,别人用它写周报、做翻译得心应手,换到你的行业里,却常常答非所问——把「复盘」理解成游戏里的复盘,把「SOP」当成一个随便拼凑的缩写。这背后其实藏着一个关键技术:大模型微调(Fine-tuning)。今天我们就用大白话,把「微调」这件事讲清楚,看看生成式AI是如何从一个「通用百事通」,变成懂你、懂业务的专属助手的。
微调到底是什么?给大模型补一堂「专业课」
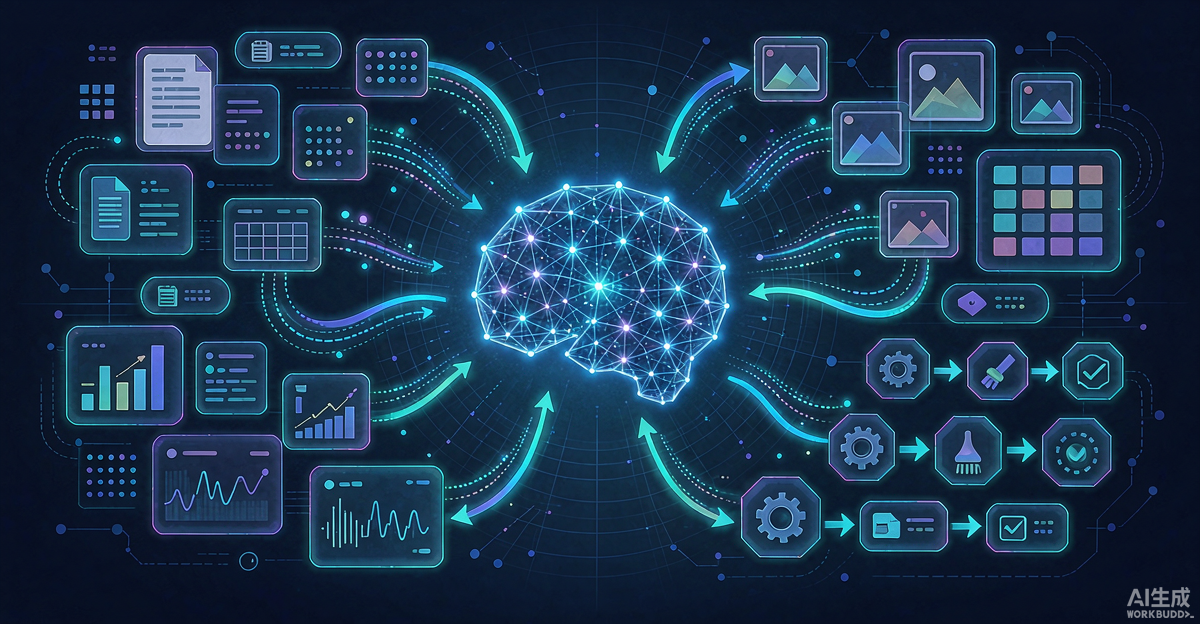
所谓微调,通俗地说,就是在一个已经训练好的通用大模型基础上,再拿一小批「定制数据」训练它一轮,让它把新学到的行业知识、语气风格和任务规范,融进原有的能力里。可以把通用大模型想象成一个刚从名校毕业、知识渊博但没上过班的学霸,而微调,就是给它安排一段针对你所在岗位的「入职培训」。
为什么不能直接从头训练一个专属模型?答案很简单:太贵、太慢。从零训练一个大模型,需要海量数据、成千上万张显卡和数月时间,动辄几千万甚至上亿的成本。而微调只需要几百条到几万条高质量样本,通常几小时到一两天就能完成,成本低到普通企业也能承受。这正是生成式AI能快速「落地」到各行各业的原因之一。
微调和提示词、RAG,到底有什么区别?
不少人会混淆三种「让AI更懂你」的手段,这里用一句话区分:提示词是在「提问时临时嘱咐」,不改变模型本身;RAG(检索增强生成)是「翻外挂的资料库」,回答前先检索你的私有文档再生成答案;而微调是「把知识真正内化进模型参数里」,从底层改变模型的行为习惯。
三者并不冲突,反而常常组合使用:先用微调让模型学会你的说话风格和任务套路,再用RAG接入实时更新的业务数据,最后用提示词做临时约束。理解了这层关系,你就能更准确地判断自己的需求该用哪种方案。
两种主流微调方法:全参与 vs 高效微调
从技术实现上看,微调大致分为两派。第一种是全参数微调,即把大模型的所有参数都参与更新,效果上限最高,但需要的内存和算力也最大,通常只有企业级团队才玩得动。第二种是高效微调,最出名的代表是LoRA(低秩适配),它只训练一小部分新增的「插件参数」,冻结原模型主体,训练又快又省显存,效果在很多场景下已经足够好,是当下中小团队和个人玩家的主流选择。
得益于开源社区的繁荣,如今像Hugging Face、以及国内通义千问、DeepSeek、智谱等官方开源的模型,配合官方或开源的微调工具,普通人也能在消费级显卡上跑一次LoRA微调,把自己的语料变成一个「会写你风格文案」的小助手。
微调能用来做什么?AIGC落地的真实场景
微调的价值,在于把通用AI工具变成「懂行」的专属生产力。几个典型场景:
场景一:让AI说「行话」
医疗、法律、金融等行业术语密集、表达严谨,通用模型容易「外行看热闹」。用高质量的行业问答数据微调后,模型能更准确地使用专业词汇,减少常识性错误,输出也更贴合行业规范。
场景二:统一品牌语气与风格
企业想让客服或营销文案保持一致的「人设」,光靠提示词很难稳定。微调可以把手头的历史优质文案作为样本,让模型稳定输出符合品牌调性的内容,这正是生成式AI在内容生产上最实用的落地方式之一。
场景三:复刻固定任务套路
比如「把会议纪要整理成结构化周报」「把商品描述改写成小红书风格」,这类格式固定的任务,用少量标注样本微调后,模型可以少犯错、少返工,真正做到开箱即用。
动手之前,先想清楚这几件事
微调虽好,但也不是万能灵药。第一,数据质量远比数量重要,几百条干净、准确、风格一致的样本,往往比几万条混杂数据效果更好;第二,微调会「遗忘」一部分通用能力,过度微调可能让模型在别的领域变笨,需要权衡;第三,隐私与合规不可忽视,涉及敏感数据的训练务必脱敏,并遵守相关法规。
对大多数个人用户来说,其实不必急于微调——先用好现成的提示词和官方AI工具,等到确有稳定的、高频的专属需求时再考虑微调,才是性价比最高的路径。
小结
大模型微调,本质是让通用的人工智能「量体裁衣」:用一小批高质量数据,把生成式AI从「百事通」打磨成「懂行的专家」。它和提示词、RAG各司其职、可以组合,全参与与LoRA高效微调则分别对应不同的成本与效果取舍。随着AIGC工具链的成熟,微调的门槛正在快速降低,普通人也有机会训练属于自己的专属AI工具。理性看待它的边界,从真实需求出发,才能让这项技术真正为你所用。
© 版权声明
文章版权归作者所有,未经允许请勿转载。
相关文章

暂无评论...