很多人对大模型的印象,还停留在「一个很会聊天的机器人」:你问一句,它答一句。但真正让这一轮人工智能发生质变的,不是它更会聊天,而是它开始「长出手脚」——能查数据库、能上网搜索、能调 API、能写代码、能订日程。支撑这一切的关键能力,叫工具调用,英文常写作 Function Calling。今天我们就用大白话讲清楚:大模型是怎么从「只会说」进化到「会动手」的,以及它对我们普通人意味着什么。
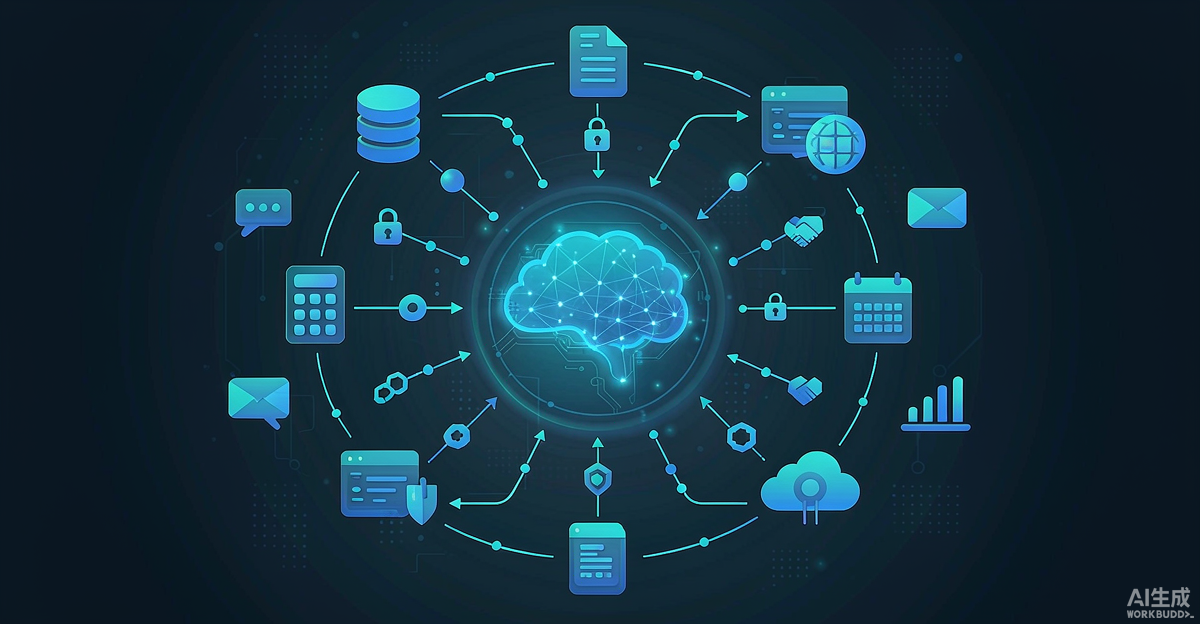
大模型为什么会「动手」之前先被卡住
大模型的本质,是根据海量文本「预测下一个词」。它脑子里装的是知识,不是实时数据,更不是执行能力。于是你会遇到两个经典尴尬:
- 知识有截止日期:它不知道今天天气、不知道你账户余额、不知道刚发布的新闻。
- 有想法却干不了活:它能告诉你「应该发一封邮件」,但它自己点不了发送按钮。
过去,人们只能把这些缺口交给提示词去补,效果有限。工具调用的出现,等于给大模型开了一扇通向外界的门——它不再孤零零地待在对话里,而是能「伸手」去调用一个外部工具,拿到真实结果后再继续回答你。
工具调用是怎么运转的
整个过程可以拆成三步,理解起来并不难。
第一步:模型判断「要不要动手」
当你问「帮我把北京今天的天气存进表格」,模型会先判断:这件事我光靠嘴说不出来,需要一个查天气的工具。于是它不再直接吐答案,而是输出一个「结构化指令」——我要调用一个叫 get_weather 的函数,参数是「北京」。
第二步:程序真的去执行
注意,真正去查天气、写表格的,是外面跑着的程序,不是模型本身。程序拿到模型的指令,调接口、取数据,得到结果再喂回给模型。这一步保证了「动作是真的、数据是真的」。
第三步:模型把结果说成人话
模型拿到真实数据后,再用自然语言组织成你要的答案。三个环节环环相扣,就构成了一个能「边查边说」的 AI 助手。
打个比方:大模型像一位坐在办公室里的「总指挥」,工具是它的「外勤人员」。总指挥下指令,外勤跑腿办事、回来汇报,总指挥再整合汇报写成结论。这正是如今各类生成式AI 产品背后的核心机制。
从 Function Calling 到 MCP:工具正在标准化
早期的工具调用,每接一个工具都要单独写一套代码,成本高、难维护。于是业内开始推动标准化协议,最有代表性的就是 MCP——模型上下文协议(Model Context Protocol)。
MCP 的思路很像电脑上的 USB 接口:以前每台设备都要配不同的插口,现在统一成一种标准,插上就能用。对 AI 工具来说,只要一个应用遵循 MCP 协议,各种大模型、各种客户端都能「即插即用」地连上它,而不用为每个模型重写一遍适配代码。
这带来的变化是深远的。对开发者,接入成本大幅下降;对普通人,则意味着我们能选用的 AI 工具会像手机 App 一样越来越多、越来越丰富。可以说,工具调用正在从「各家各干各的」,走向「一个标准通吃」,这是 AIGC 生态走向成熟的重要一步。
普通人能用它做什么
你未必需要写代码,但已经能间接享受到工具调用的好处。举几个身边的例子:
- 一句话查数据:让 AI 帮你查最新股价、天气、航班,而不再是「我的知识截止到某年」。
- 跨应用联动:让它读完你的表格、整理成周报,再自动发到群里。
- 定制私人助理:接入你的日历、邮箱、待办,让它成为真正懂你日程的管家。
想上手体验,最省心的路径是优先选择官方与正版平台,比如 ChatGPT、Claude、通义千问、豆包、Kimi、DeepSeek、文心一言等,它们大多已内置了联网搜索、代码执行、文件处理等工具能力。如果你愿意折腾一点,开源生态里的 LangChain、LangGraph,以及 Ollama、LM Studio 这类本地运行方案,也能让你在自己的电脑上搭一个「会动手」的私有 AI 助手,全程不碰盗版或破解,安全也省心。
也要看清它的边界
工具调用虽强,但并非万能,用之前最好心里有数。
- 会做不等于做得对:工具返回了错误数据,模型可能照单全收,所以关键信息要自己复核。
- 权限要克制:别轻易给 AI 开放能删数据、能付款的高危工具,先用只读、低风险的场景练手。
- 隐私要留意:涉及个人敏感数据时,确认清楚它会把数据发到哪里、是否留在本地。
把 AI 工具当「助手」而不是「全权代理」,是当下最稳妥的用法。
小结
工具调用,正是大模型从「会聊天的嘴」走向「会干活的手」的那道分水岭。它让人工智能第一次真正连接了真实世界的数据与动作,也让生成式AI 和 AIGC 从「生成内容」进一步迈向「完成任务」。随着 MCP 等标准协议走向成熟,未来的 AI 工具只会更顺手、更普及。对普通人来说,不必等什么「颠覆性时刻」——打开一个正版 AI 助手,试着让它帮你查一次数据、整理一份文档,你就已经站在了这场变革的最前沿。
© 版权声明
文章版权归作者所有,未经允许请勿转载。
相关文章


暂无评论...